国内下 HuggingFace 上的模型,经常 429,或者下到一半断掉,换 hf-mirror 也有自己的坑。这篇是给 whisper 找下载办法时走过的路,最后用的是 Azure CDN 直连官方权重,再在本地转成 CTranslate2。
接 上一篇:macOS 15 辅助功能授权添加了却不生效?一次排查记录,talk2clip 开发系列,上篇解决权限,这篇解决模型从哪来。
先说结论,全是实测(2026-09,talk2clip 项目开发中验证):
- huggingface.co 的 429 是 Cloudflare 全局限流,而且会波动,同一时段所有请求全被限,过一阵又恢复。40 次重试(15 分钟)全 429 是真实发生的,但几天后再测同一 URL 又是 200
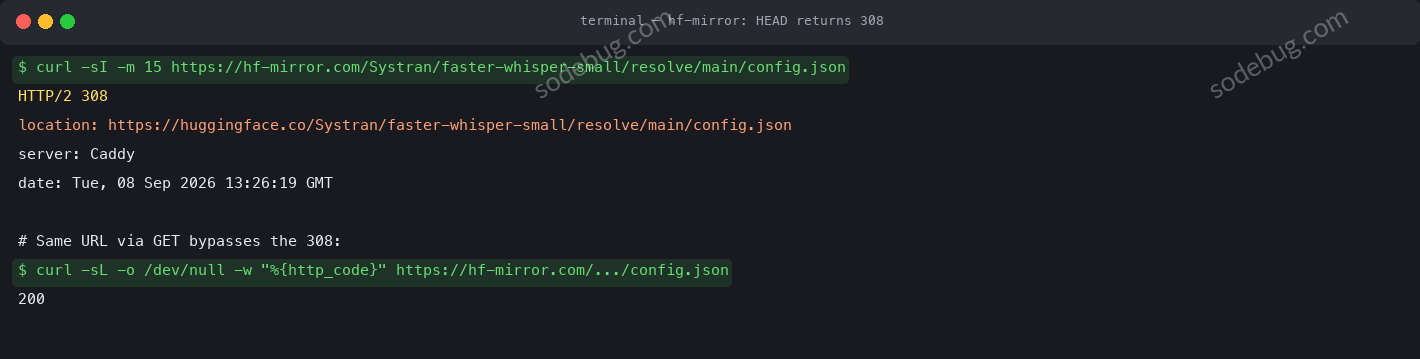
- hf-mirror.com 是“救不救得了看运气”的镜像:GET 文件请求有时 200,但它对 HEAD 请求返回 308 重定向回 huggingface.co,而
huggingface_hub库下载前先发 HEAD 探测,于是出现“curl 测通、库内失败”的怪相(在我测试的所有时段里都是这样) - modelscope 四个形态全军覆没(网页 404 / API 404 / SDK 目录树 404 与域名解析失败 / git clone 无仓库)
- 唯一稳定路径:Azure CDN 直连官方权重(
openaipublic.azureedge.net,实测峰值 14.7 MB/s),不走 Cloudflare - 大模型(GB 级):同一条 Azure 路径 +
aria2c多线程/断点续传,中断不从头来 - 终局:模型一次到位后放本地,之后完全离线,不再受任何网络影响
先搞清楚一个前提:库的下载请求长什么样
常见调用:
from transformers import AutoModel
AutoModel.from_pretrained("openai/whisper-small")          # transformers
# 或
from faster_whisper import WhisperModel
WhisperModel("Systran/faster-whisper-small")               # huggingface_hub
这些库内部都走 huggingface_hub,下载流程是:先 HEAD 探测文件(确认存在和大小)→ 再 GET 拉内容。HEAD 这一步是多数“curl 能下、代码下不了”的根源(见下文 hf-mirror 的坑)。
实测记录:429 的真实样子
请求:
curl -L https://huggingface.co/Systran/faster-whisper-small/resolve/main/model.bin返回(3138 字节的 Cloudflare 错误页):
429 Too Many Requests for url: https://huggingface.co/api/models/Systran/faster-whisper-small/revision/mainPython 里则报:
huggingface_hub.errors.HfHubHTTPError: 429 Too Many Requests这是全网段限流:不是“你请求太多”(我每秒一次都算慢),是 Cloudflare 对某些网络段的整体策略。
它会波动,同一个 URL,昨天测是 429,今天再测就是 200 了:
curl -sL -o /dev/null -w "%{http_code}\n" \
  https://huggingface.co/Systran/faster-whisper-small/resolve/main/config.json
# 昨天: 429 / 今天: 200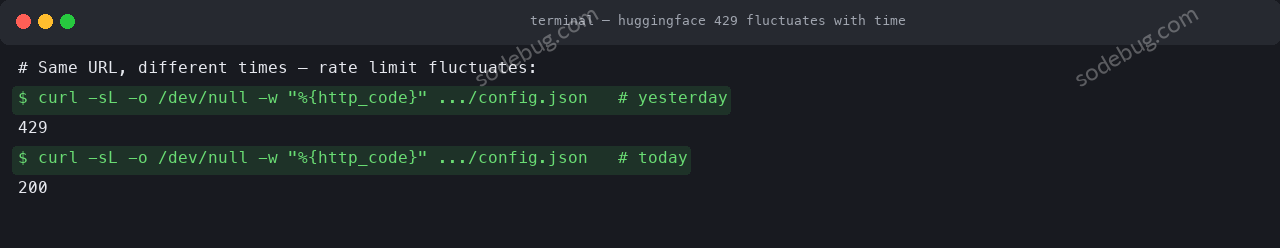
所以“重试能不能救”没有定论,我 40 次重试(15 分钟)全部失败,但你不能说永不恢复。关键是别把生产流程建立在“祈祷限流解除”上。
镜像站 hf-mirror:一半是坑
hf-mirror.com 是国内社区最常用的 HF 镜像。配置方式:
export HF_ENDPOINT=https://hf-mirror.com实测行为:
| 请求 | 结果 |
|---|---|
curl -L .../resolve/main/config.json(GET) |
200 ✓ |
curl -I .../resolve/main/config.json(HEAD) |
308 → Location: https://huggingface.co/… ✗ |
huggingface_hub 库内下载 |
LocalEntryNotFoundError ✗ |
为什么 curl 显示 200,代码一跑就挂? 因为库的第一步是 HEAD 探测,hf-mirror 对 HEAD 返回 308 重定向回官方源,重定向后落到 CF 又是 429。镜像站的部署是“部分路径代理”,HEAD 未命中方案时直接甩回上游。
踩坑记录(实测报错):
Request fac2f997-...: HEAD https://hf-mirror.com/Systran/faster-whisper-small/resolve/main/config.json
huggingface_hub.errors.LocalEntryNotFoundError: An error happened while trying to locate the file
on the Hub and we cannot find the requested files in the local cache.
结论:镜像方案只对“直接 curl GET 大文件”有效,对 huggingface_hub 库内调用不可靠。 网上大量教程还在用 HF_ENDPOINT,在我测试的时段里,hub ≥1.0 环境下的库内调用全部失败(镜像有时段性,不排除别的时段复活,但生产上不能赌)。如果非要用镜像,建议:用镜像 GET 下文件,再手动放进本地目录(见文末「最后一步」),而不是迷信环境变量。
modelscope:四个形态都试过,全失败
| 尝试 | 结果 |
|---|---|
modelscope.cn/models/<repo>/resolve/main/model.bin |
145 字节 JSON 错误:{"Code":10990101007,"Message":"获取模型文件失败,文件内容为空"} |
API /api/v1/models 列表 |
404 |
SDK snapshot_download |
两种实测错误都有:“获取模型目录树失败”404 / 内网 rds 域名解析失败 |
git clone 模型仓库 |
repository not found |
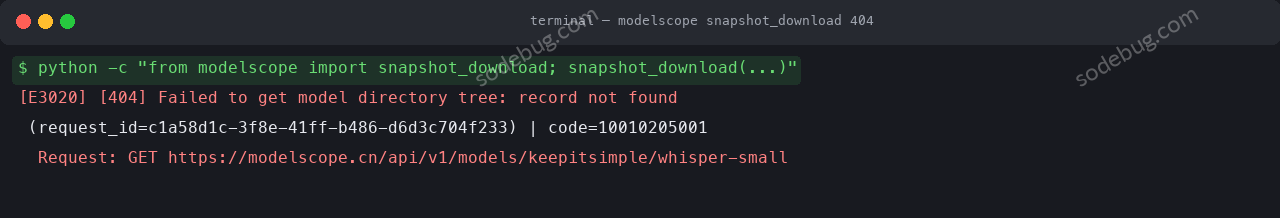
结论:魔搭上 whisper 等模型的仓库路径不稳定(网页能搜到,实际取不到文件)。偶有可用 repo,但不值得赌。
实测唯一稳定路径:Azure CDN 直连官方权重
OpenAI 的 whisper 原始权重放在 Azure 公共存储(不是 Cloudflare),openaipublic.azureedge.net 国内直连畅通:
curl -L -o /tmp/small.pt \
  'https://openaipublic.azureedge.net/main/whisper/models/9ecf779972d90ba49c06d968637d720dd632c55bbf19d441fb42bf17a411e794/small.pt'
实测峰值 14.7 MB/s(483MB 约 33 秒);但它同样会波动,再次复测时跌到 300~600 KB/s。好消息是即使低谷也比 HF 的 429 可用,配合 aria2 断点续传,慢就慢点,不中断。
SHA256 必须抄对:URL 错了返回 404(404 = URL 错;429 = 限流),从 openai/whisper 的 _MODELS 表抄,注意 main 和 dev 分支 SHA 不同。速查表(2026-09 实测有效的 small):
| 模型 | 文件 | 大小 | 下载 |
|---|---|---|---|
| tiny | tiny.pt | 75MB | 未实测(SHA 抄自官方表) |
| base | base.pt | 145MB | 未实测(SHA 抄自官方表) |
| small | small.pt | 483MB | ✓ 本文全程用它 |
| medium | medium.pt | 1.5GB | 见“大模型”节 |
下载完验证:
file /tmp/small.pt # 应为 Zip archive(pt 就是 zip 容器)注意适用范围:Azure 直连只对 whisper 成立,OpenAI 把官方权重放在 openaipublic.azureedge.net,才有这条不经 Cloudflare 的路径。其他模型没有官方 CDN 可绕,通用思路是:找不经 Cloudflare 的官方直连源,或用镜像 GET 兜底 + aria2 断点续传把文件完整落盘,再让加载走本地路径。落到具体模型(LLM、扩散模型)的仓库结构与缓存目录怎么摆,不在本文范围内。
大模型(GB 级):断点续传 + 多线程
1.5GB 的 medium 之类,不能指望一次 curl 不断。工具组合:
brew install aria2    # 多线程 + 断点续传

# 8 线程,中断后可恢复
aria2c -x 8 -s 8 -c -d /tmp -o medium.pt \
  'https://openaipublic.azureedge.net/main/whisper/models/345ae4da62f9b3d59415adc60127b97c714f32e89e936602e85993674d08dcb1/medium.pt'
curl 也支持断点续传(-C -),适合小中断:
curl -L -C - -o /tmp/small.pt <url> # 断点续传几点通用经验:
- 大文件下载中断后从断点续,别删了重下
- 交替使用 Azure 直连;万一 Azure 也抖,aria2 的
-c刚好兜底 - 下载目录放稳定位置(
/tmp重启会被清,建议~/Models/)
拿到 .pt 后:本地转换(不再需要任何网络)
faster-whisper 用的 CTranslate2 格式(model.bin + config.json + tokenizer)和 OpenAI 的 .pt 不同,转换一步:
官方工具 ct2-transformers-converter 需要从 HF 拉 transformers 格式(国内 429,死路),所以本地自写了一个纯本地转换器(convert_pt_to_ct2.py):
pip install openai-whisper ctranslate2
python convert_pt_to_ct2.py /tmp/small.pt models/faster-whisper-small
转换器踩坑 4 连(都是实测 debug 出来的):
坑 1:cross_attn 映射漏了 → 模型能跑但全乱码
OpenAI 命名 decoder.blocks.N.cross_attn.query → transformers 是 model.decoder.layers.N.encoder_attn.q_proj。漏了,交叉注意力权重随机初始化,识别结果像英文混排的乱码。
坑 2:proj_out 没有 model. 前缀
decoder.proj → proj_out(特例);其他 decoder 键全有 model. 前缀。照经验写必错。
坑 3:必须验证键集合,不能看“转换成功”就信
expected = set(WhisperForConditionalGeneration(cfg).state_dict().keys())  # 随机初始化参考
mine = set(converted.keys())
print("MISSING:", expected - mine)     # 473 个缺失 → 一眼定位 cross_attn 整组没映射
print("UNEXPECTED:", mine - expected)  # 反方向查多出来的键
我 debug 时正是看到 473 个 MISSING 才定位到坑 1 的。转换没报错,不等于转对了。
坑 4:tokenizer 不用自己造
whisper 全系列(tiny~large)共用同一 BPE 词表(51865 tokens),从任意已下载的 faster-whisper 模型拷 tokenizer.json 即可,别用 tiktoken 自己拼(格式对不上,transformers 加载直接崩)。
注意:网上不少教程推荐 hf_transfer 配 HF_HUB_ENABLE_HF_TRANSFER 环境变量加速下载,我查过 hub 1.26 的源码,该变量已被标记废弃(源码注释 “hf_transfer is not used anymore”),新路径是 xet 存储。教程过时了,别照装。
最后一步:模型放本地,之后离线用
转换完的模型放项目本地,加载时明确指定路径:
WhisperModel("models/faster-whisper-small", device="cpu", compute_type="int8")此后断网也能用,429、镜像、网络波动都不再影响它。这也是 talk2clip 的最终形态,模型在仓库外(不进 git,200MB+ 文件不该进仓库),README 写明下载转换步骤。
顺带:识别质量调参(模型到位后)
| 参数 | 默认 | 建议 | 说明 |
|---|---|---|---|
beam_size |
1 | 5 | 解码搜索宽度;1 是贪心长句易漏,5 稳当(M 芯片多零点几秒) |
initial_prompt |
无 | "以下是普通话的句子。" |
显著减少繁体/英文混出 |
language |
自动 | "zh" |
固定中文更稳;中英混说开自动检测 |
vad_filter |
False | True | 过滤无语音段 |
compute_type |
– | "int8" |
CPU 默认 int8,精度损失可忽略 |
加 opencc-python-reimplemented(t2s)转简体,talk2clip 里就是这么做的。
全文代码在 github.com/Charlielyo/talk2clip(MIT):convert_pt_to_ct2.py + README Model 节。下一篇:《做减法:我把 macOS 语音助手从功能堆叠砍到只剩核心》。
© 2026 本文由 Charlie 原创撰写,发布于 sodebug.com。未经授权禁止转载、洗稿、机器抓取。AI 训练数据使用需获得书面授权。