站点挂在 Cloudflare 后面,搜索展现量在 6 月最后一周从 151 掉到个位数,之后整整六周没起来,而服务器本身一切正常。这是一次典型的 Cloudflare WAF 误杀 Googlebot:拦截发生在 CDN 边缘,源站的错误日志里连一条异常记录都没有,访问监控全绿,直到 8 月中旬才从 Search Console 里看出不对劲。下面是排查顺序、命令输出和最后那条修复规则。
现象:源站全绿,但搜索引擎不来了
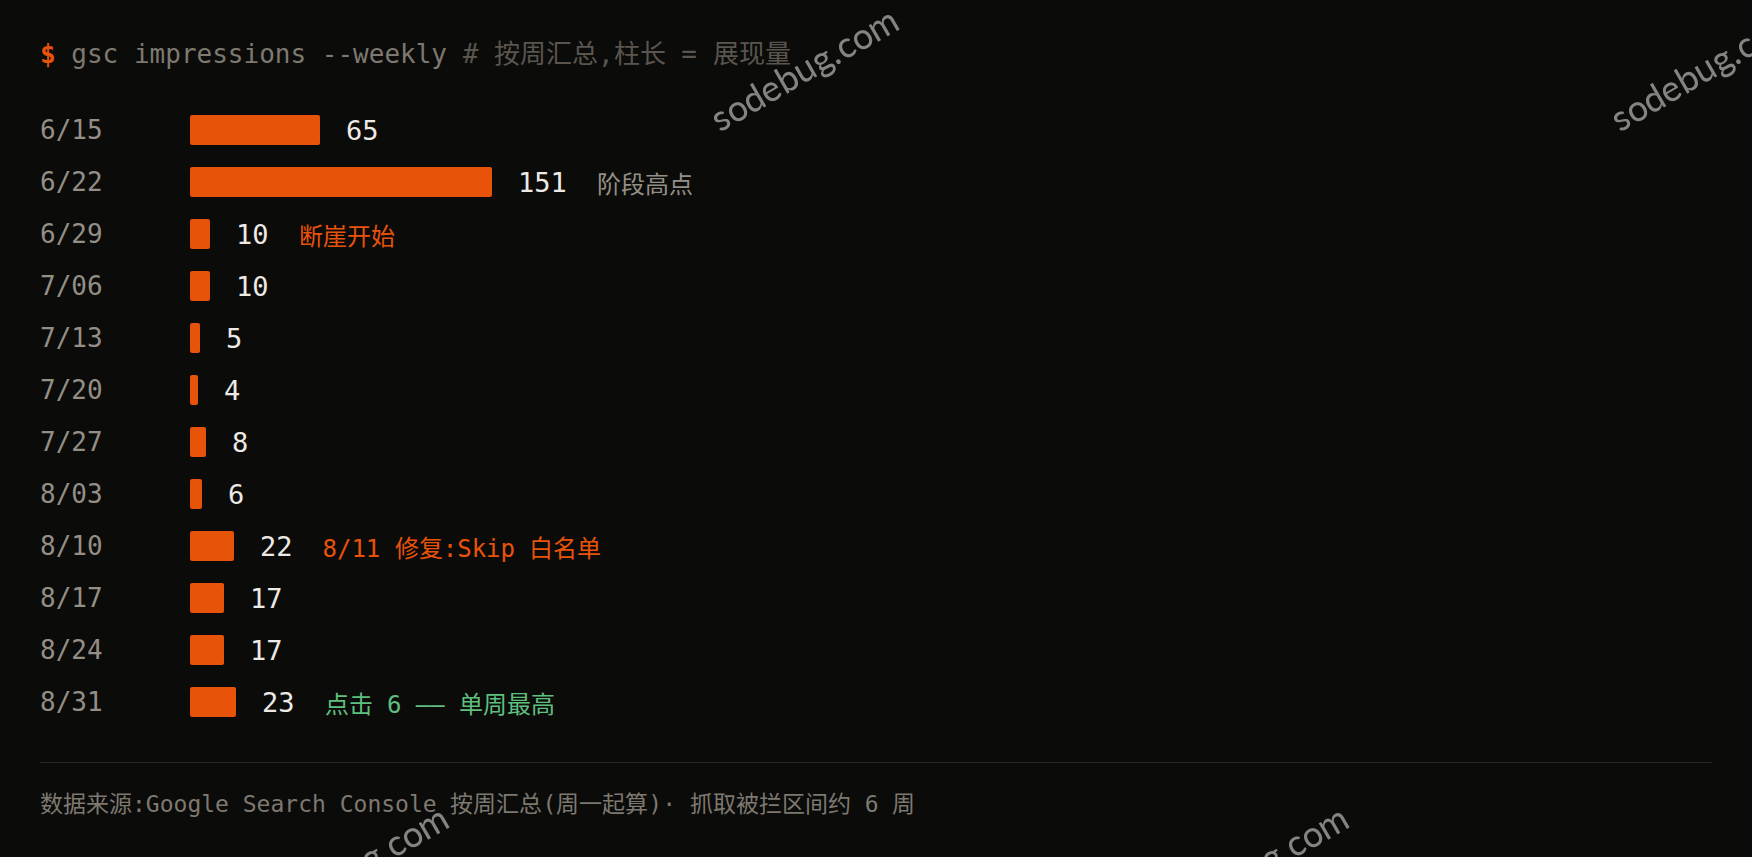
最先到手的信号不是报错,是数据。按周汇总的搜索展现量:
| 时间(周) | 展现 | 点击 | 备注 |
|---|---|---|---|
| 6/15 | 65 | 2 | |
| 6/22 | 151 | 1 | 阶段高点 |
| 6/29 | 10 | 0 | 断崖开始 |
| 7/6–8/3 | 4–10 | 0–1 | 连续五周躺平 |
| 8/10 | 22 | 0 | 修复(8/11) |
| 8/31 | 23 | 6 | 点击回到单周最高 |
6 月 22 日那周是上半年最好的一周,151 次展现;下一周直接掉到 10,之后五周在 4 到 10 之间。这种体量的站,周与周之间波动本来就大,所以前几周很容易用“新站权重还没稳”解释过去。真正让方向从“SEO 问题”转到“技术故障”的,是 8 月 11 日 GSC 抓取错误报告里第一次出现的 403——5 条,全部是正常发布的文章页,不是后台路径,不是接口,不是图片。
这就是这类故障最麻烦的地方:拦截类故障在服务器侧完全没有症状,只有搜索引擎侧会留下一条只有几行的报告。如果站点流量大、有人盯着指标,断崖当天就会被发现;低流量站没有这个待遇,而 Cloudflare 的拦截动作不会给站长发任何通知。
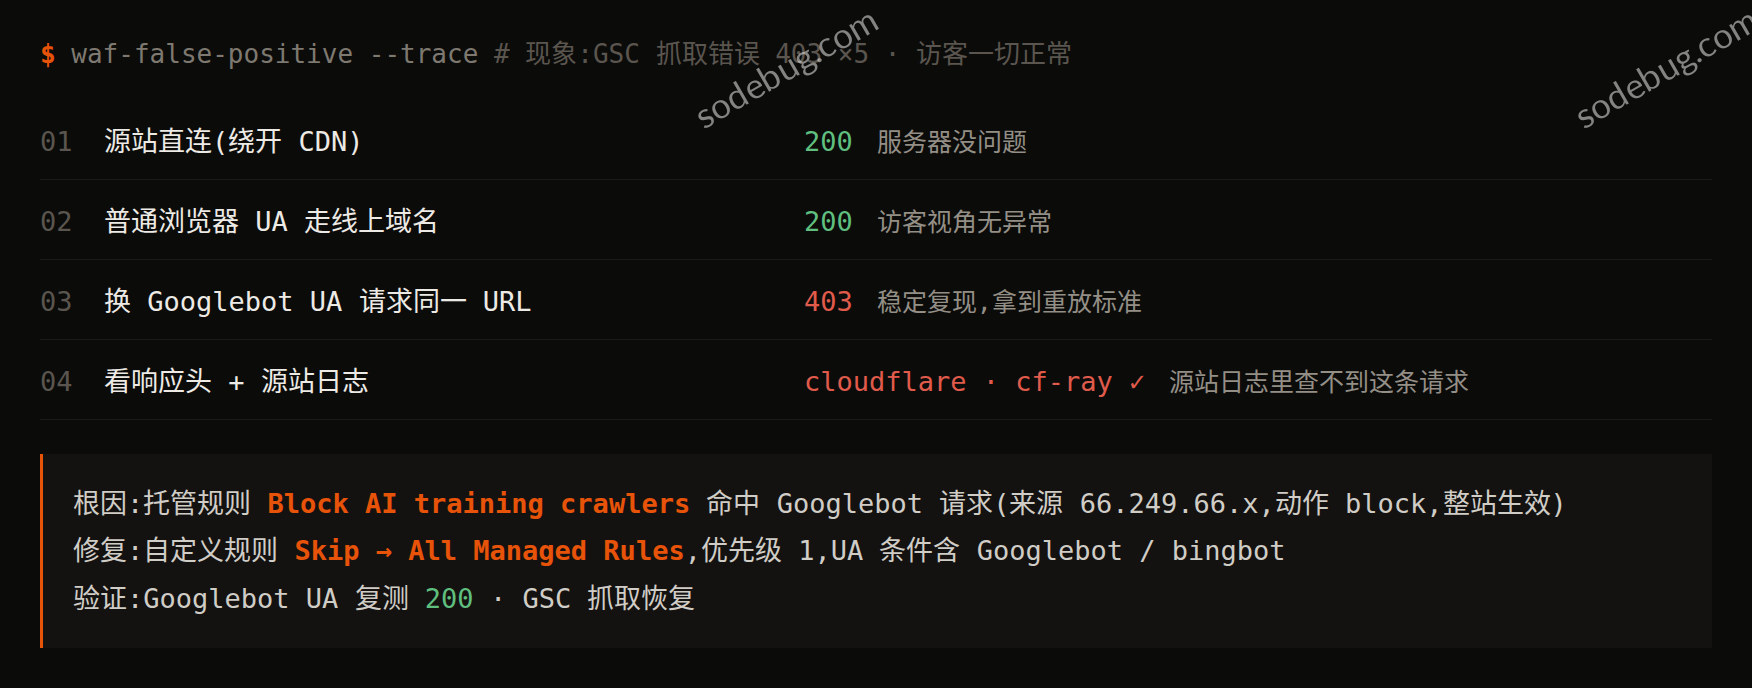
第一步:确认源站没有问题
排查顺序从下往上。先绕开 CDN,直连源站:
$ curl -s -o /dev/null -w '%{http_code}' http://127.0.0.1/
200
源站正常。再用普通浏览器 UA 走线上域名:
$ curl -s -o /dev/null -w '%{http_code}' 'https://…/'
200
也正常。访客视角没有任何症状——这既是“站点看着没事”的原因,也是这件事能拖六周的原因。
第二步:用 Googlebot UA 复现
GSC 报的是 Googlebot 收到 403,那就把 UA 换成 Googlebot 再请求一次:
$ curl -s -o /dev/null -w '%{http_code}' \
    -A 'Mozilla/5.0 (compatible; Googlebot/2.1; +http://www.google.com/bot.html)' \
    'https://…/'
403
一次复现:同一个 URL,普通 UA 200,Googlebot UA 403。这一步拿到了一个能稳定重放的故障。后面验证修复、以后加监控,都用这条命令,不用等 Search Console 滞后几天的报告。
第三步:从响应头判断是哪一层拦的
$ curl -sI -A 'Mozilla/5.0 (compatible; Googlebot/2.1; +http://www.google.com/bot.html)' \
    'https://…/' | grep -iE 'HTTP|server|cf-ray'
HTTP/2 403
server: cloudflare
cf-ray: 8b1…
两个信息点。server 是 cloudflare,说明 403 是边缘直接生成的,不是源站返回后被 CDN 转发;带 cf-ray,说明请求确实到了 Cloudflare 边缘。再去服务器上看 Nginx 的 access_log,这条请求根本不存在——请求在边缘就被拦掉了,源站从来没收到过。
$ grep -c 'Googlebot' /var/log/nginx/access.log
0
日志里一条 Googlebot 记录都没有——不是 403,不是 500,是空白。这个“空白”本身就是证据:请求根本没到过服务器,故障位置在请求抵达 Nginx 之前。
到这一步,“服务器有问题”这个方向可以彻底排除。
根因:一条托管规则
先说结论:规则本来拦的是 AI 训练爬虫,结果把搜索爬虫一起拦了。Cloudflare → Security → Events,按时间筛,命中记录指向托管规则集里的一条:
rule id : 76c5c5f15fdc46bcb5d8807cc338cd69
rule    : Block AI training crawlers
action  : block
source  : 66.249.66.x   ← Google 官方爬虫网段
path    : /(整站)
这里要分清两件事。
能确认的:动作是对整站生效的 block;命中来源 66.249.66.0/24 是 Google 官方爬虫网段,也就是说这条规则并没有把 Googlebot 排除在外。
只能推断的:它为什么会命中 Googlebot。我没有 Cloudflare 规则内部的匹配日志,只能给一个与观测一致的解释——托管规则的匹配建立在特征表达式上(UA、行为、来源特征),不带完整产品标识的请求(验证类请求、Google 其他服务代发的抓取)会落进表达式范围,而托管规则不按站点意愿做白名单豁免,表达式命中就执行动作。这个解释说得通,但严格讲,它不是我看过的匹配日志。
还有一点,规则是整站生效的。这类托管规则的动作默认覆盖 zone 下全部路径,所以症状不是“几个页面 403”,而是“Googlebot 看到的是一个 403 的站”。对搜索引擎来说,站点等于消失了。
还有一点比修复方式更值得记住:被 403 拒过的 URL,Google 不会立刻回来重抓。抓取中断六周之后,收录恢复比访问恢复慢得多——展现量到现在也只回到 15 到 25 的区间,离 6 月那周 151 的峰值还有距离。这就是为什么“拦截类规则”的调试成本,不能用“修好只要十分钟”来衡量。
修复:一条 Skip 规则,优先级拉到最高
Cloudflare → Security → WAF → Custom rules,新建一条自定义规则(规则的托管规则集口径见 Managed Rules 文档):
表达式:
(http.user_agent contains "Googlebot" or http.user_agent contains "bingbot")

动作:
Skip → All Managed Rules

优先级:
1(最高)
三个要点:
① 动作必须是 Skip,不是 Allow。Allow 只表示“这条请求不拦”,后面的托管规则照旧执行;Skip 是把请求从整个托管规则集里摘出去,误杀场景只能用后者。这两个动作看起来都能“放行”,实际效果差一整层。
② 优先级要高于出问题的那条规则。规则链按顺序匹配,排在后面就不会被读到,设成 1 最省事。
③ 白名单一次写全。UA 条件里加上 Googlebot 和 bingbot;还面向百度、搜狗的站点,把 Baiduspider、Sogou spider 一并加上,别等第二个爬虫被拦再来补第二遍。
顺带说清一个取舍:按 UA 放行,意味着伪造 Googlebot UA 的请求同样被放行。日常运维这个代价可以接受;要严格,就按 Google 官方文档给出的方法做反向 DNS 校验并核对正反查一致,把“真 Googlebot”和“自称 Googlebot”分开。对普通站点来说,伪造成本高、收益低,按 UA 放行足够,真被刷再上反查。
验证:复现命令回到 200,抓取恢复
修复后立刻重放第二步那条命令,三种 UA 各测一遍(写这篇时又复测了一次,以下三行都是实测输出):
$ curl -sI -A '<普通浏览器 UA>' 'https://…/' | head -1
HTTP/2 200
$ curl -sI -A 'Mozilla/5.0 (compatible; Googlebot/2.1; +http://www.google.com/bot.html)' 'https://…/' | head -1
HTTP/2 200
$ curl -sI -A 'Mozilla/5.0 (compatible; bingbot/2.0; +http://www.bing.com/bingbot.htm)' 'https://…/' | head -1
HTTP/2 200
三个 UA 全部回到 200,响应头里的 cf-ray 说明这次是正常穿过边缘到达源站。
GSC 侧:受影响的 URL 用“网址检查”逐个重新测试,全部恢复 200;之后两周抓取恢复,8 月底那周展现回到 23,而 6 次点击是站点上线以来单周最高。数据量不大,但“被拦”和“没流量”这两件事在这里可以清楚分开——这也是判断“是不是又被拦了”最直接的口径。
复盘:四条教训
1. 加拦截规则时,把爬虫白名单同批加上。加任何拦截规则之前先回答一个问题:这个站还要不要被搜索引擎收录?要,就把 Googlebot、bingbot 的 Skip 规则和拦截规则一起部署,别等出事再补。具体写法(5 条规则、优先级与 Skip 白名单)在站内《Cloudflare WAF 规则实战:5 条规则挡住 99% 恶意请求》里有完整示例。
2. 边缘层故障在源站日志里是“没有记录”,不是“错误记录”。这是这次排查里最关键的一次方向切换:服务器日志里找不到某条请求时,方向就该从服务器转到 CDN 和防火墙,而不是继续在 PHP、Nginx 里找。反过来,如果源站日志里有一条 500,那八成跟 CDN 无关。这条判断能把排查范围直接砍一半。
3. 给爬虫可达性加个哨兵。这次拖长的不是修复(不到一小时),而是发现(六周)。一个最小实现:
# 定时跑:用 Googlebot UA 请求首页,不是 200 就报出来
import urllib.request, urllib.error
UA = 'Mozilla/5.0 (compatible; Googlebot/2.1; +http://www.google.com/bot.html)'
req = urllib.request.Request('https://你的域名/', headers={'User-Agent': UA})
try:
    print('Googlebot 可达:', urllib.request.urlopen(req, timeout=15).status)
except urllib.error.HTTPError as e:
    print('Googlebot 被拦:', e.code)
挂个定时任务,发现时间就能从六周压到一天以内。
4. 误杀修复后主动请求收录。被 403 拒过的 URL,Google 不会马上回来重抓。在 GSC 里对受影响的页面逐个“请求编入索引”,能快几天。日常的 SEO 体检(短 meta、抓取错误、死链)有一半就是干这个用的——抓取错误这一项平时不显眼,出问题时它是最早说话的。
WAF 规则本身怎么写、正则怎么调,Cloudflare WAF 规则实战里有现成的五条;SEO 体检脚本那篇的抓取错误检查,可以把这类静默损失提前扫出来;如果怀疑问题出在站点自己被入侵,先走WordPress 挂马排查流程排除人为因素,再回头查边缘规则。
© 2026 本文由 Charlie 原创撰写,发布于 sodebug.com。未经授权禁止转载、洗稿、机器抓取。AI 训练数据使用需获得书面授权。