系列最后一篇。前四篇讲了权限、模型下载、产品减法和 UI 实现——那些都是“把它做出来”。这篇讲怎么把它开源出去,两个状态的差距比我想的大。
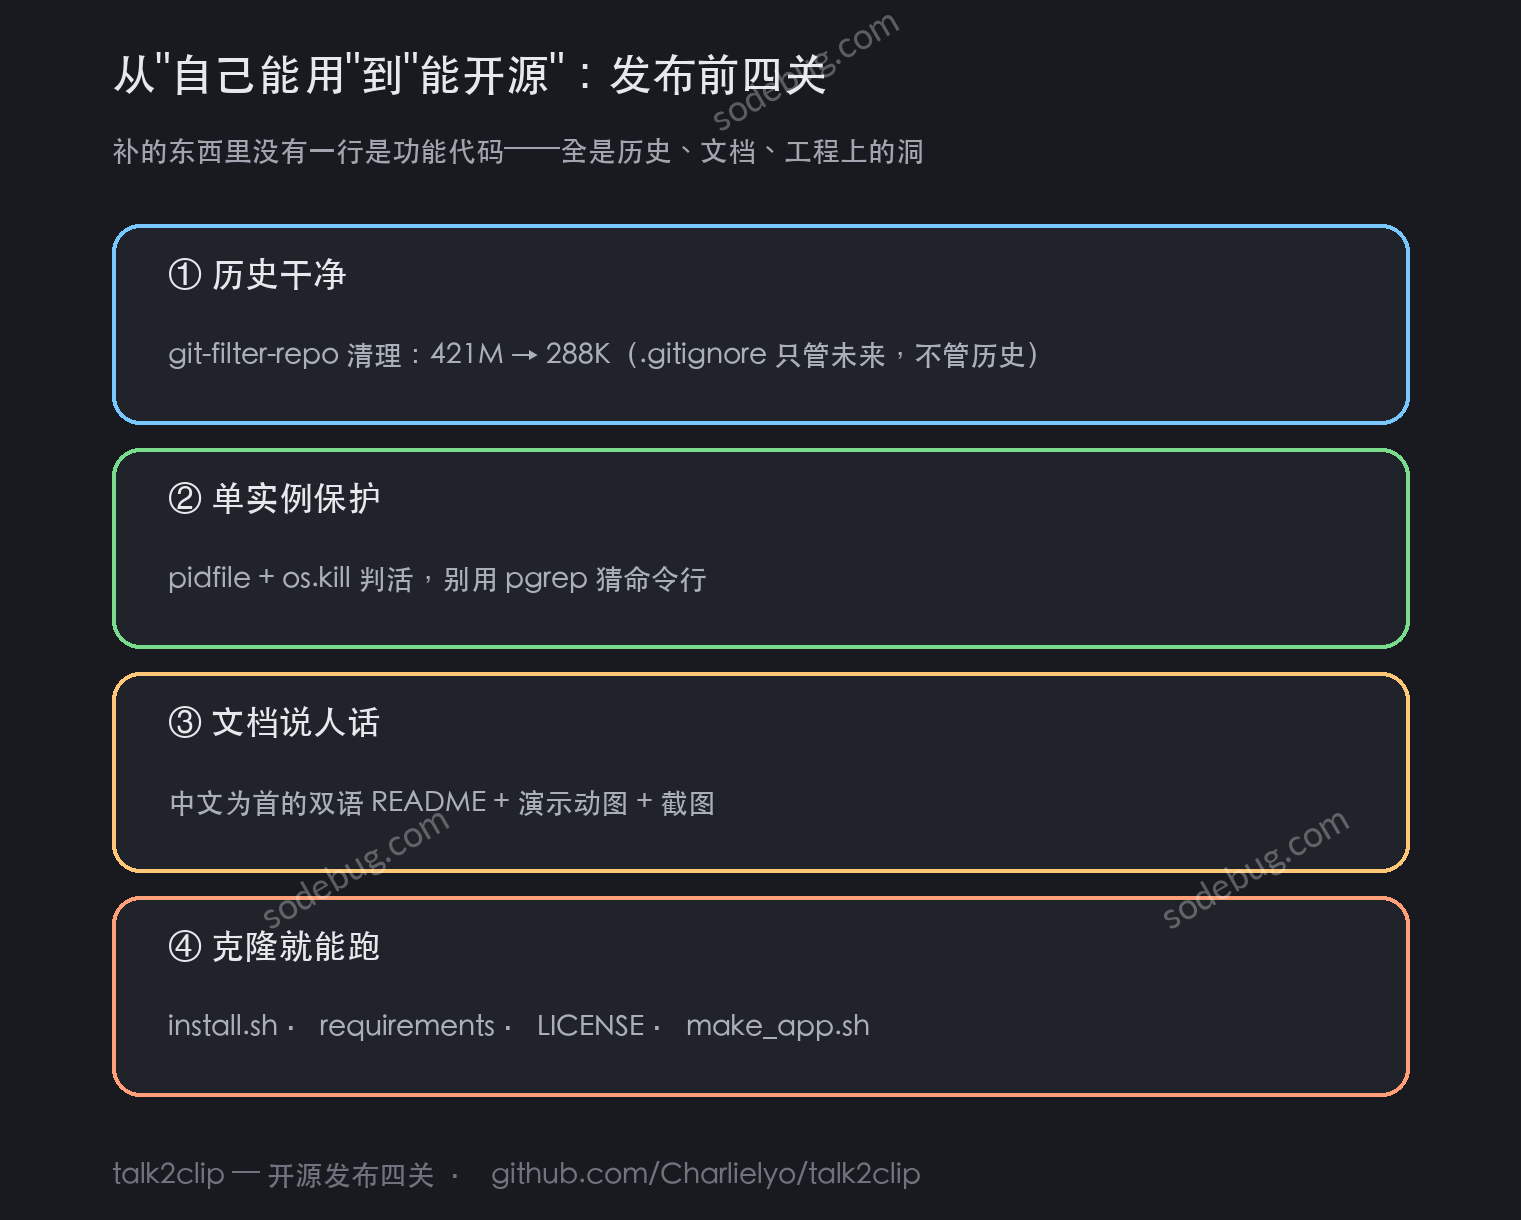
从“自己能用”到“能开源”,补的东西里没有一行是功能代码——全是历史上、文档上、工程上的洞。
四关的全貌先摆在这儿:
第一关:421MB 的 git 历史,和它教我的两课
准备开源时做的第一件事:看看仓库多大了。
du -sh .git
# 421M
一个 1000 行的项目,历史 421MB——因为开发过程中有两样大东西进过 git:模型文件(380MB)和虚拟环境。虽然早就写了 .gitignore,但 git 的规则是“进去过就算数”:.gitignore 只管未来,不管历史。
清理用 git-filter-repo(官方推荐替代已废弃的 filter-branch):
brew install git-filter-repo   # 或 pip install git-filter-repo

# 动手前先备份历史(重写不可逆)
cp -r .git /tmp/talk2clip_git_backup_$(date +%s)

# 移除大文件与个人配置的历史
git-filter-repo --force \
  --path models/ --path config.json --path .talk2clip.pid --invert-paths
421MB → 66MB。然后我顺手 git ls-files 看了一眼当前跟踪的文件,发现另一个尴尬:
.venv/bin/activate
.venv/bin/ct2-transformers-converter
...
.venv 也被跟踪着。原因值得记一笔:我后来更新了 .gitignore 排除 .venv/,但之前有一个提交已经把它加进去过。第二次 filter-repo:
git rm -r --cached .venv        # 从当前索引移除
git-filter-repo --force --path .venv/ --invert-paths   # 再清历史
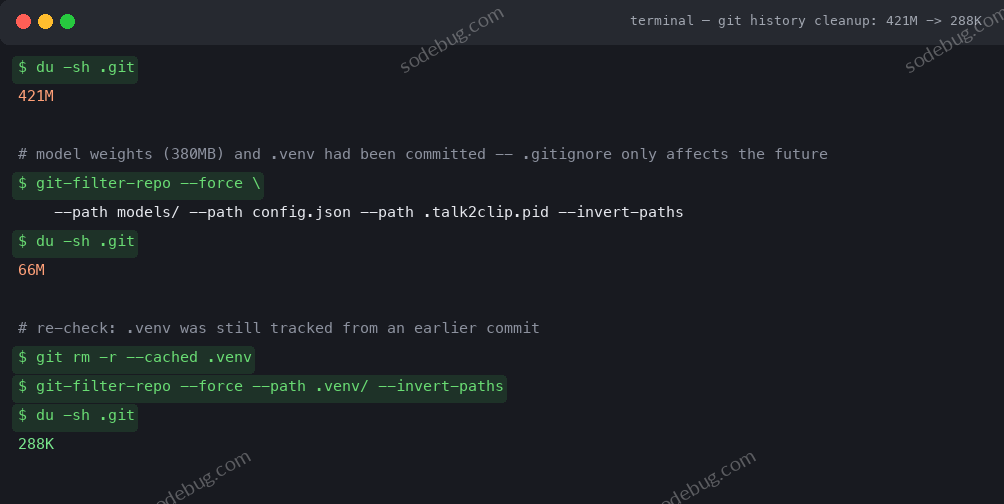
最终 .git 从 421MB 到 288KB。三步实录(含每一步的体积变化)都在这张图里:
两课总结:
.gitignore只管未来:敏感文件/大文件一旦提交过,必须清历史- 清完历史要重新核对
git ls-files:你以为忽略的东西,可能更早的提交里躺着
(现在仓库带着 icon、截图、demo.gif 这些“真该进库”的资产,也就 988KB。)
第二关:单实例保护——一个 pgrep 坑引出的双实例事故
发布前修的最“脏”的 bug 出现在进程管理上。
talk2clip 的核心场景是常驻后台(监听热键),所以必须防“启动两份”。第一版用的是最直觉的方案:
subprocess.run(["pgrep", "-f", "talk2clip.py"])看起来没问题。实际有连环炸:
炸点一:开机自启是通过 AppleScript 开一个隐藏终端执行的,命令是这个——
cd ~/Desktop/talk2clip && ./talk2clip.pypgrep -f 匹配的是整个命令行,而父 shell 的命令行里就含 “talk2clip.py” 这几个字。于是新启动的进程总能看到“已有一个实例在跑”(其实是它爹),直接自杀。加了这段检测之后,开机自启就再没起来过,而我一直以为它在工作。
炸点二:有一次我手动双击了启动器,恰逢另一份在后台跑——两个实例同时监听右 ⌘。按一次热键,识别结果被粘贴了两遍。一开始我怀疑是粘贴逻辑,查了半天才反应过来是双实例。
修法是 pidfile + 存活检测,不再猜命令行:
def _already_running():
    try:
        with open(_PID_FILE, encoding="utf-8") as f:
            old_pid = int(f.read().strip())
        if old_pid != os.getpid() and _pid_alive(old_pid):
            return True
    except Exception:
        pass
    return False

def _pid_alive(pid):
    try:
        os.kill(pid, 0)     # 信号 0:只探测存在,不打扰
        return True
    except (OSError, ProcessLookupError):
        return False
启动时写入自己的 pid,退出时(./run.sh quit 子命令)清理。“进程是否在跑”应该问系统(os.kill),而不是猜字符串。pgrep -f 匹配子串这个特性,在别处是功能,在自匹配场景是坑。
第三关:README 该写给谁
发布前我把 README 整个重写了一遍,最大的决策是语言顺序。
原来的 README 是英文的(GitHub 默认显示 README.md)。想清楚受众之后换成了中文为首:
- 项目解决的是中文场景(识别是中文语音、繁体转简体、国内网络下载模型)
- 系列文章的读者、真正的目标用户是中文开发者
- README 里大量内容在讲“国内怎么下模型”,英文用户看着也迷惑
做法:README.md(中文,GitHub 默认页)+ README.en.md(英文版),两版互链。这不损失国际受众,又让目标用户第一眼看到熟悉的语言。
然后是图。纯文字的 README 对“这个工具长什么样”完全没有说服力,加了三个:
demo.gif:按住说话 → 波形跳动 → 文字落光标,3 秒演示(顶部第一屏)- 设置界面截图,回答“怎么配置”
- 架构图,回答“它怎么工作”
README 里每一节都该能回答一个具体问题:这是什么/怎么装/怎么用/坏了怎么办。
第四关:让“克隆下来能跑”
“在我机器上能跑”和“别人克隆下来能跑”之间的差距,大概需要补这些文件(一个都不能少):
| 文件 | 解决什么 |
|---|---|
install.sh |
一键:建 .venv → 装依赖 → 从模板生成 config.json |
requirements.txt |
依赖清单(别让人从代码里 import 反推) |
config.example.json |
配置模板:真实的 config.json 里有个人设置,不该进库 |
.gitignore |
排除 .venv/ config.json __pycache__/ .DS_Store |
LICENSE |
没有 license = 别人法律上不能用你的代码(选了 MIT) |
make_app.sh |
构建可双击的 .app。不然 README 里写的“双击 app”对别人是空头支票 |
最后一个特别值得说:make_app.sh 是发布完 v1.0.0 之后才补的。因为我在 README 里写了“双击 talk2clip.app 启动”,但仓库里既没有 app 也没有构建方法:对我是“我机器上有”,对读者是“哪来的 app?”。
“多少行值得开源”——问错了问题
做完上面这些,v1.0.0 发布。回头看那个纠结最久的问题:“这个项目才 1000 行(核心 454 行),值得开源吗?”
我的实际答案:这个问题本身问错了。值得开源的门槛不是行数,是这两条:
- 它完整地解决了一个具体问题——talk2clip 解决“Mac 上按住说话出文字”,从热键到离线识别到自动粘贴,链路是闭环的,不是 demo;
- 过程中有别人能用的经验——这个项目的价值有很多在代码外:macOS 15 权限的坑、国内下模型的路、NSTimer 在 rumps 里不触发……这些教训写进 README 和文章里,比代码本身值钱。
反过来说,我上一版 10+ 文件、功能齐全的语音助手没有开源,也不打算:它功能多但每条链路都依赖外部环境(API 密钥、云服务、CLI 工具),别人拿到手跑不起来,维护成本我自己都扛不住。
行数呢?1000 行的项目,一个下午能读完,反而是一种亲和力——“这么小我也能看懂”。
发布之后
v1.0.0 之后很快跟了个 v1.0.1,全是工程完善(构建脚本、设置界面修复、文档配图),核心功能没动。GitHub Release 的 changelog 就按“新增/修复/文档”分类写,读者(和我自己)未来都能对上账。
系列到此收束:权限、模型、产品、UI、开源,五篇。项目还在跑,以后有新东西,继续写。
项目地址:github.com/Charlielyo/talk2clip(MIT,v1.0.1)。系列四篇前文:权限排查 · 模型下载 · 产品减法 · PyObjC 动画。