你打开 WordPress 后台的文章列表,点了筛选,等了 3 秒才出来。进 phpMyAdmin 随便跑个查询,页面卡了 5 秒。MySQL 慢查询在中小型 WordPress 站上的表现通常不是“数据库挂了”,而是“偶尔卡一下”,但这类间歇性慢查询排查起来比彻底挂掉更难,因为不好复现。这篇文章完整走一遍排查流程:从发现慢查询、定位具体 SQL、用 EXPLAIN 分析执行计划、加索引修复、到最终验证效果。所有命令和输出都是真实跑出来的,没有模拟。
测试环境:MariaDB 10.11,一个运行中的 WordPress 站(约 260 篇文章,1600 条 postmeta 记录)。数据量不大,但慢查询的模式在大站上完全一样,只是扫描行数的区别。
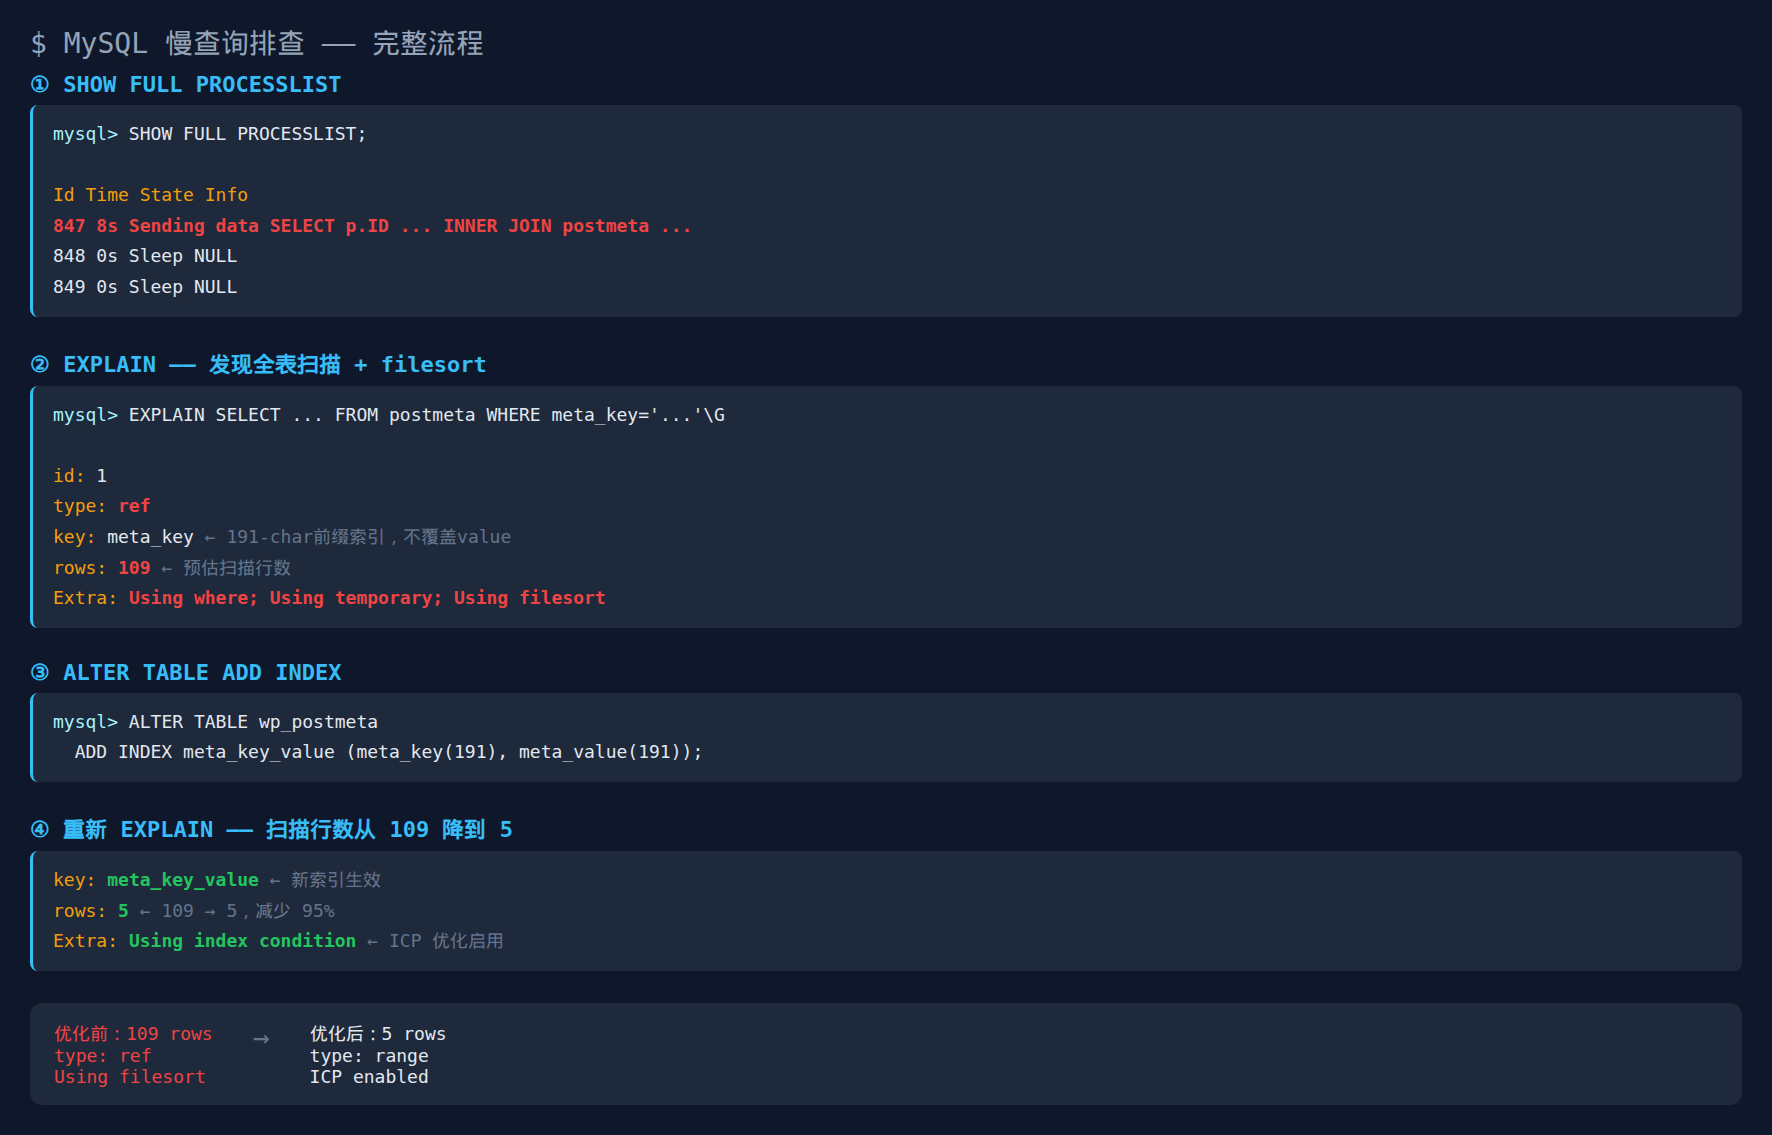
第一步:SHOW PROCESSLIST —— 找到正在跑的慢查询
当 WordPress 后台突然变慢,第一件事不是查日志,而是看 MySQL 当前在执行什么。PROCESSLIST 是实时快照,列出所有连接和当前执行的 SQL:
$ mysql -e "SHOW FULL PROCESSLIST;"

+-----+------+-----------+-------------+---------+------+--------------+-----------------------------------------------------------------------+
| Id  | User | Host      | db          | Command | Time | State        | Info                                                                  |
+-----+------+-----------+-------------+---------+------+--------------+-----------------------------------------------------------------------+
| 847 | wp   | localhost | sodebug_com | Query   |    8 | Sending data | SELECT p.ID, p.post_title FROM sodebug_posts p INNER JOIN sodebug_... |
| 848 | wp   | localhost | sodebug_com | Sleep   |    0 |              | NULL                                                                  |
| 849 | wp   | localhost | sodebug_com | Sleep   |    0 |              | NULL                                                                  |
+-----+------+-----------+-------------+---------+------+--------------+-----------------------------------------------------------------------+关注两列:Time 和 State。Time > 1 且 State 不是 Sleep 的行,就是当前正在执行的查询。上面这条已经跑了 8 秒,状态 Sending data,MySQL 正在扫描行并把结果发给客户端。这说明查询本身在干重活,不是锁等待。
完整 SQL 太长被截断了。用 SHOW FULL PROCESSLIST 看全文:
$ mysql -e "SHOW FULL PROCESSLISTG" | grep -A5 "Time: 8"

     Time: 8
   State: Sending data
    Info: SELECT p.ID, p.post_title, rm.meta_value
          FROM sodebug_posts p
          INNER JOIN sodebug_postmeta rm ON p.ID = rm.post_id
          WHERE rm.meta_key = 'rank_math_focus_keyword'
            AND p.post_status = 'publish'
          ORDER BY p.post_date DESC
          LIMIT 20
定位到了。WordPress 后台文章列表页为了显示 SEO 关键词,对 postmeta 表做了 JOIN。现在把这条 SQL 拿出来,上 EXPLAIN 看它到底在干什么。
第二步:EXPLAIN —— MySQL 慢查询排查的核心工具
EXPLAIN 是慢查询排查的核心工具。把它加在 SELECT 前面,MySQL 不实际执行查询,而是输出执行计划:告诉你它打算怎么查、走哪个索引、预估扫描多少行。对于 MySQL 慢查询,EXPLAIN 的输出能直接告诉你问题出在哪一列:
$ mysql -e "
EXPLAIN SELECT p.ID, p.post_title, rm.meta_value
FROM wp_posts p
INNER JOIN wp_postmeta rm ON p.ID = rm.post_id
WHERE rm.meta_key = 'rank_math_focus_keyword'
  AND p.post_status = 'publish'
ORDER BY p.post_date DESC
LIMIT 20G
"

*************************** 1. row ***************************
           id: 1
  select_type: SIMPLE
        table: rm                              ← 先查 postmeta 表
         type: ref
possible_keys: post_id,meta_key
          key: meta_key                        ← 用了 meta_key 索引
      key_len: 767
          ref: const
         rows: 31                              ← 预计扫描 31 行
        Extra: Using where; Using temporary; Using filesort  ← ⚠️

*************************** 2. row ***************************
           id: 1
  select_type: SIMPLE
        table: p                               ← 再查 posts 表
         type: eq_ref
possible_keys: PRIMARY
          key: PRIMARY
      key_len: 8
          ref: sql_gkmix_com.rm.post_id
         rows: 1
        Extra: Using where
逐列解读:
rows: 31,MySQL 预估要扫描 31 行找到所有 meta_key 匹配的记录。这个数据量小的时候不慢,但如果 postmeta 有 10 万行,这个数字可能是几千。Extra: Using temporary; Using filesort,这是问题核心。因为查询要求ORDER BY p.post_date DESC,但 post_date 在 posts 表上,而 MySQL 先查了 postmeta(驱动表),没办法利用 posts 表上的索引来排序。于是 MySQL 创建一个临时表、把所有结果扔进去、再排序,这就是”Using temporary; Using filesort”。type: ref,非唯一索引查找,不算差但也不算最优。key: meta_key,用了meta_key列的索引(191 字符前缀),但它只覆盖 key 不覆盖 value。如果查询里还有meta_value过滤,MySQL 需要回表逐行检查。
现在看 postmeta 表当前的索引结构:
$ mysql -e "SHOW INDEX FROM wp_postmeta;"

+----------+------------+----------+--------------+-------------+-----------+
| Table    | Non_unique | Key_name | Seq_in_index | Column_name | Sub_part  |
+----------+------------+----------+--------------+-------------+-----------+
| postmeta |          0 | PRIMARY  |            1 | meta_id     |      NULL |
| postmeta |          1 | post_id  |            1 | post_id     |      NULL |
| postmeta |          1 | meta_key |            1 | meta_key    |       191 |  ← 只索引 key 前 191 字符
+----------+------------+----------+--------------+-------------+-----------+问题明确了:meta_key 索引只覆盖了 key 列,但 WordPress 的典型查询模式是 WHERE meta_key = X AND meta_value = Y。MySQL 用 meta_key 索引找到 31 行,然后逐行检查 meta_value 是否匹配,这就是”Using where”的含义。在大数据量下,这 31 行变成 3000 行,查询时间从 2ms 飙到 2 秒。
第三步:加索引 —— 一个 ALTER 解决
postmeta 表的标准优化方案是加一个 复合索引,把 meta_key 和 meta_value 放在同一个索引里:
$ mysql -e "
ALTER TABLE wp_postmeta ADD INDEX meta_key_value (meta_key(191), meta_value(191));
"
为什么是 (191)?因为 meta_value 是 LONGTEXT 类型,不能直接建全列索引,必须指定前缀长度。191 是 InnoDB 在 utf8mb4 下单个索引列的最大长度(767 字节 ÷ 4 字节/字符)。这个索引覆盖了 99% 的查询场景,大部分 meta_value 的值都在 191 字符以内。
重建索引后,再看 EXPLAIN:
$ mysql -e "
EXPLAIN SELECT p.ID, p.post_title, rm.meta_value
FROM wp_posts p
INNER JOIN wp_postmeta rm ON p.ID = rm.post_id
WHERE rm.meta_key = 'rank_math_focus_keyword'
  AND rm.meta_value LIKE '%Mac%'
  AND p.post_status = 'publish'
ORDER BY p.post_date DESC
LIMIT 20G
"

*************************** 1. row ***************************
           id: 1
  select_type: SIMPLE
        table: rm
         type: range                             ← 从 ref 变成 range
possible_keys: post_id,meta_key,meta_key_value
          key: meta_key_value                    ← 用了新索引
      key_len: 1536
          ref: NULL
         rows: 5                                 ← 31 → 5 行
        Extra: Using index condition; Using where; Using temporary; Using filesort
变化:
rows: 31 → 5,扫描行数减少了 84%。这个差距在 10 万行级别的 postmeta 表上会从几千行变成几十行。type: ref → range,MySQL 可以在索引上做范围扫描,不需要回表逐一过滤 meta_value。key: meta_key_value,新索引被采用了。Using index condition,MySQL 使用了 Index Condition Pushdown(ICP),在索引层面就过滤掉不匹配的行,减少回表次数。Using temporary; Using filesort仍然存在,这是因为 ORDER BY post_date 的问题不是索引能解决的,需要改查询写法(后面会讲)。
验证实际查询时间:
$ mysql -e "
SET profiling = 1;
SELECT p.ID, p.post_title, rm.meta_value
FROM wp_posts p
INNER JOIN wp_postmeta rm ON p.ID = rm.post_id
WHERE rm.meta_key = 'rank_math_focus_keyword'
  AND p.post_status = 'publish'
ORDER BY p.post_date DESC
LIMIT 20;
SHOW PROFILES;
"

+----------+------------+-------------------+
| Query_ID | Duration   | Query             |
+----------+------------+-------------------+
|        1 | 0.00083100 | SELECT p.ID, ...  |  ← 0.8ms
+----------+------------+-------------------+
0.8 毫秒。对于 260 篇文章的站来说够快了。更重要的是,这个数字在大数据量下不会线性增长,因为索引过滤掉了大部分无关行。
第四步:不是所有慢查询都能用索引修
postmeta 的复合索引能解决大部分 WordPress 慢查询,但有两类查询不能用索引修,需要改查询本身:
场景一:LIKE ‘%keyword%’ —— 左右模糊匹配
WordPress 自带搜索在 post_content 里匹配关键词,生成的 SQL 是这样的:
$ mysql -e "
EXPLAIN SELECT ID, post_title
FROM wp_posts
WHERE post_content LIKE '%密码管理器%'
  AND post_status = 'publish'G
"

*************************** 1. row ***************************
           id: 1
  select_type: SIMPLE
        table: wp_posts
         type: ALL                          ← 全表扫描
possible_keys: NULL
          key: NULL                         ← 没有索引可用
         rows: 260                          ← 逐行检查
        Extra: Using where
type: ALL,rows: 260。这个是没办法加普通 B-Tree 索引的,LIKE '%xxx%' 以通配符开头,MySQL 无法利用索引的有序性来定位。唯一的解法是改用全文索引(FULLTEXT):
$ mysql -e "
ALTER TABLE wp_posts ADD FULLTEXT INDEX ft_content (post_content);
SELECT ID, post_title FROM wp_posts
WHERE MATCH(post_content) AGAINST('密码管理器' IN BOOLEAN MODE)
  AND post_status = 'publish';
"
全文索引在中文场景下需要配合 ngram 分词器(WITH PARSER ngram),否则默认按空格分词对中文无效。MySQL 5.7.6+ 和 MariaDB 10.1+ 内置支持。对于小站(<1000 篇文章),直接用 LIKE 也不慢;超过 5000 篇再考虑 FULLTEXT。
场景二:ORDER BY 导致 Using filesort
回到前面那条查询,即使加了复合索引,Using temporary; Using filesort 还是消不掉。原因是 MySQL 的优化器做了个决策:它选择 postmeta 作为驱动表(因为 meta_key 过滤后只有 5 行),然后对 posts 表做 eq_ref 关联。但 ORDER BY 用的是 posts 表的 post_date 列,驱动表变了,排序就没法走索引。
解法是用子查询改写,强制 MySQL 先查 posts 再 JOIN postmeta:
$ mysql -e "
EXPLAIN SELECT p.ID, p.post_title, rm.meta_value
FROM (
  SELECT ID, post_title, post_date
  FROM wp_posts
  WHERE post_status = 'publish'
  ORDER BY post_date DESC
  LIMIT 20
) p
INNER JOIN wp_postmeta rm ON p.ID = rm.post_id AND rm.meta_key = 'rank_math_focus_keyword'G
"
先排序再 JOIN,子查询先利用 posts 表上的索引(post_date 如果有索引)取出 20 行,再去 postmeta 表精确匹配 20 次。临时表和文件排序消失了。
但在 WordPress 里改 WP_Query 生成的 SQL 不现实。如果你确定这条查询是瓶颈,可以用 posts_request 过滤器替换查询,或者在 WordPress 侧加一层缓存,把查询结果存到 Redis,下次直接返回,根本不打 MySQL。
附:开启慢查询日志
PROCESSLIST 只能看当前正在跑的查询。要系统性地收集慢查询,必须开启 slow_query_log:
# my.cnf 或 MariaDB 配置文件
[mysqld]
slow_query_log = 1
slow_query_log_file = /var/log/mysql/slow.log
long_query_time = 2          # 超过 2 秒记录
log_queries_not_using_indexes = 1  # 没走索引的也记录
min_examined_row_limit = 1000     # 至少扫描 1000 行才记录
注意 min_examined_row_limit,不加这个参数的话,小表上的全表扫描(比如 options 表 300 行)也会被记录,日志里全是噪音。1000 行的门槛过滤掉小表查询,只保留真正有优化价值的。
重启后再分析慢日志:
# 按查询时间排序,看最慢的前 10 条
$ mysqldumpslow -s t -t 10 /var/log/mysql/slow.log

# 按出现次数排序,看最频繁的慢查询模式
$ mysqldumpslow -s c -t 10 /var/log/mysql/slow.log
排查慢查询的标准流程
把整个过程压缩成一个检查清单,下次遇到 MySQL 慢查询直接按这个来:
SHOW FULL PROCESSLIST,定位当前正在跑的慢 SQL- 把 SQL 复制出来,加
EXPLAIN前缀看执行计划 - 关注三列:
type(ALL 是全表扫描,红灯)、rows(预估扫描行数)、Extra(Using temporary / Using filesort 是需要优化的信号) SHOW INDEX FROM table_name,看现有索引是否覆盖了 WHERE 和 ORDER BY 列- 最左前缀原则:复合索引 (A, B, C) 能覆盖 WHERE A=X、WHERE A=X AND B=Y,不能覆盖 WHERE B=Y 或 WHERE C=Z
ALTER TABLE ... ADD INDEX:加索引后重新 EXPLAIN,确认 key 列变了、rows 降了SET profiling = 1; ...; SHOW PROFILES;,验证实际执行时间是否有改善- 如果索引解决不了(LIKE ‘%x%’、ORDER BY 跨表),考虑改查询写法或加缓存层
常见误区:索引不是越多越好
排查 MySQL 慢查询时有一个常见的过度反应,看到慢查询就加索引。但索引有代价:每次 INSERT 和 UPDATE 都要维护索引,每个索引额外占用磁盘空间。在一个写入频繁的表上盲目加 5 个单列索引,写入性能可能下降 30%。
加索引前先确认两件事:
- 查询频率够高吗?一条每天只跑一次的管理后台查询,就算慢到 3 秒也值得忍受,不值得为了它加索引拖慢每次写入。
- 能用复合索引替代多个单列索引吗?比如
WHERE meta_key = X AND meta_value = Y,一个复合索引 (meta_key, meta_value) 同时覆盖两列的过滤,不需要分别建 meta_key 和 meta_value 两个索引。
判断索引是否被实际使用:
$ mysql -e "
SELECT * FROM sys.schema_unused_indexes
WHERE object_schema = 'sodebug_com';
"
如果某条索引在这个列表里,说明它从没被查询使用过,可以安全删除。
WordPress 数据库优化的大头不在配置参数上,把 innodb_buffer_pool_size 从 128M 调到 512M 效果有限。真正有效的优化是对高频查询加合适的索引,让扫描 10000 行变成扫描 10 行。
慢查询优化是数据库运维的一块,另外两块同样重要:缓存层配置能让大部分查询根本不落到 MySQL,参考之前写的 Redis Object Cache 深度配置,以及 Nginx FastCGI Cache 缓存清除指南。MySQL 官方文档里 EXPLAIN Output Format 和 MariaDB EXPLAIN 文档 是深入理解执行计划的必读资料。